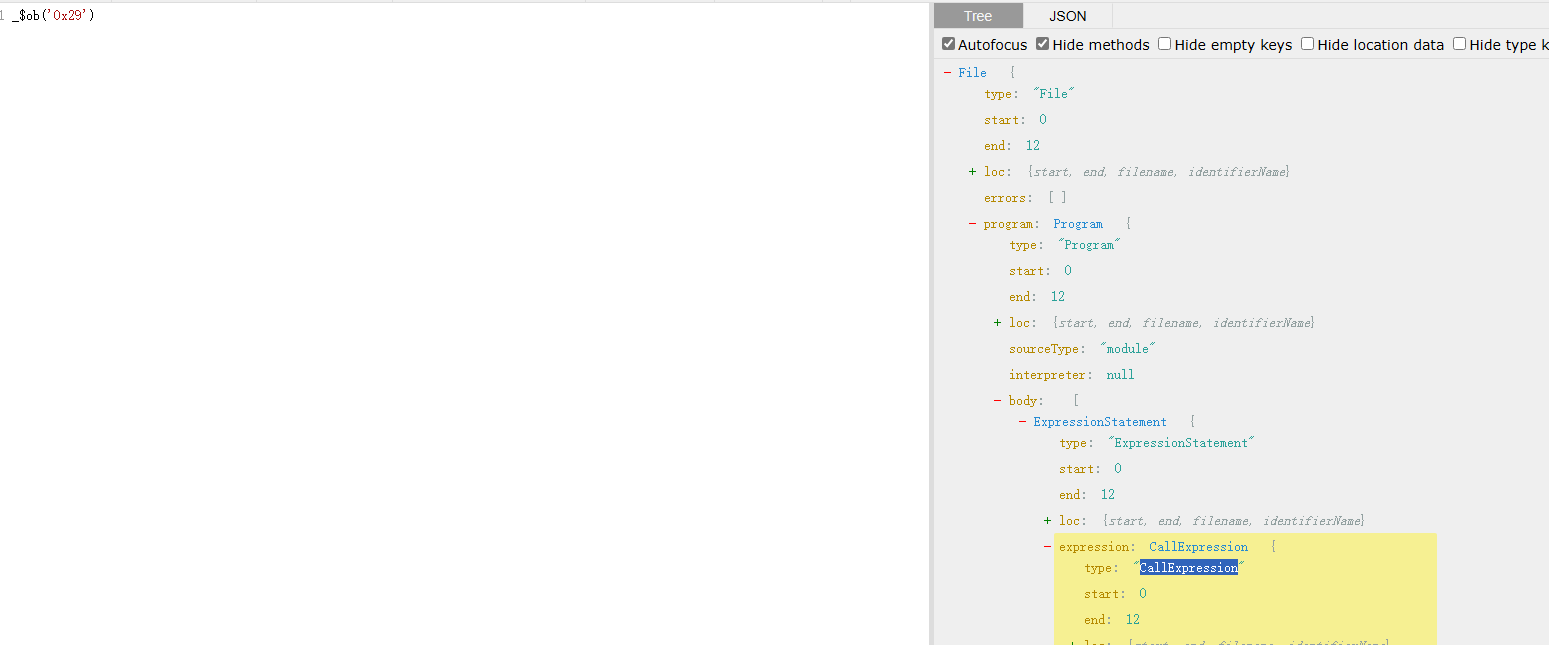
AST(Abstract Syntax Tree),中文抽象语法树,简称语法树(Syntax Tree),是源代码的抽象语法结构的树状表现形式,树上的每个节点都表示源代码中的一种结构。语法树不是某一种编程语言独有的,JavaScript、Python、Java、Golang 等几乎所有编程语言都有语法树

AST 有一个在线解析网站:https://astexplorer.net/

语法树没有单一的格式,选择不同的语言、不同的编译器,得到的结果也是不一样的,在 JavaScript 中,编译器有 Acorn、Espree、Esprima、Recast、Uglify-JS 等,使用最多的是 Babel

AST 在编译中的位置

在编译原理中,编译器转换代码通常要经过三个步骤:词法分析(Lexical Analysis)、语法分析(Syntax Analysis)、代码生成(Code Generation)

词法分析

词法分析阶段是编译过程的第一个阶段,这个阶段的任务是从左到右一个字符一个字符地读入源程序,然后根据构词规则识别单词,生成 token 符号流,比如 isPanda('🐼'),会被拆分成 isPanda,(,'🐼',) 四部分,每部分都有不同的含义,可以将词法分析过程想象为不同类型标记的列表或数组。
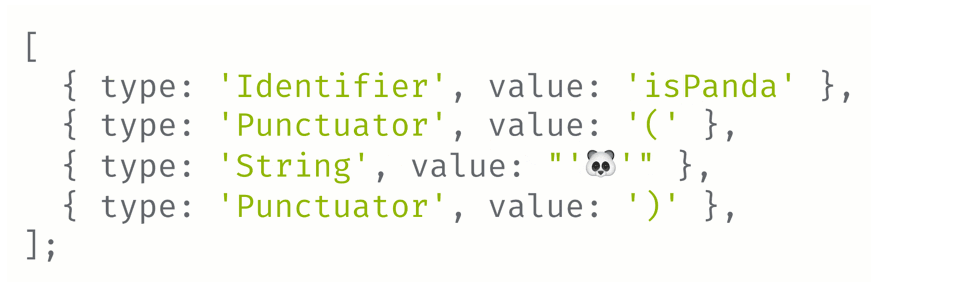
image-20230417112516793

语法分析

语法分析是编译过程的一个逻辑阶段,语法分析的任务是在词法分析的基础上将单词序列组合成各类语法短语,比如“程序”,“语句”,“表达式”等,前面的例子中,isPanda('🐼') 就会被分析为一条表达语句 ExpressionStatement,isPanda() 就会被分析成一个函数表达式 CallExpression,🐼 就会被分析成一个变量 Literal 等,众多语法之间的依赖、嵌套关系,就构成了一个树状结构,即 AST 语法树。
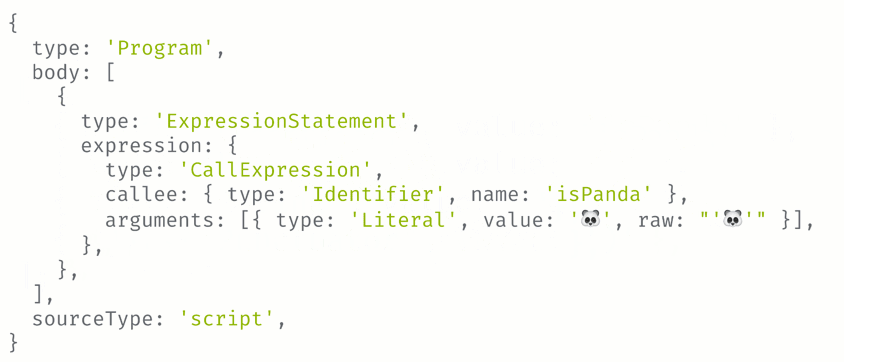
image-20230417112714051

代码生成

代码生成是最后一步,将 AST 语法树转换成可执行代码即可,在转换之前,我们可以直接操作语法树,进行增删改查等操作,例如,我们可以确定变量的声明位置、更改变量的值、删除某些节点等,我们将语句 isPanda('🐼') 修改为一个布尔类型的 Literal:true,语法树就有如下变化:
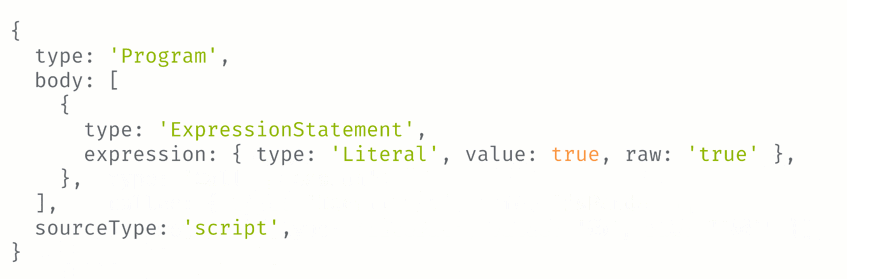
image-20230417141919553

Babel 简介

Babel 是一个 JavaScript 编译器,也可以说是一个解析库,Babel 中文网:https://www.babeljs.cn/ ,Babel 英文官网:https://babeljs.io/ ,Babel 内置了很多分析 JavaScript 代码的方法,我们可以利用 Babel 将 JavaScript 代码转换成 AST 语法树,然后增删改查等操作之后,再转换成 JavaScript 代码。

Babel 包含的各种功能包、API、各方法可选参数等,都非常多,本文不一一列举,在实际使用过程中,应当多查询官方文档,或者参考文末给出的一些学习资料。Babel 的安装和其他 Node 包一样,需要哪个安装哪个即可,比如 npm install @babel/core @babel/parser @babel/traverse @babel/generator

在做逆向解混淆中,主要用到了 Babel 的以下几个功能包,本文也仅介绍以下几个功能包:

  1. @babel/core:Babel 编译器本身,提供了 babel 的编译 API;
  2. @babel/parser:将 JavaScript 代码解析成 AST 语法树;
  3. @babel/traverse:遍历、修改 AST 语法树的各个节点;
  4. @babel/generator:将 AST 还原成 JavaScript 代码;
  5. @babel/types:判断、验证节点的类型、构建新 AST 节点等。

@babel/core

Babel 编译器本身,被拆分成了三个模块:@babel/parser、@babel/traverse、@babel/generator,比如以下方法的导入效果都是一样的:

1
2
3
4
5
const parse = require("@babel/parser").parse;
const parse = require("@babel/core").parse;

const traverse = require("@babel/traverse").default
const traverse = require("@babel/core").traverse

@babel/parser

@babel/parser 可以将 JavaScript 代码解析成 AST 语法树,其中主要提供了两个方法:

  • parser.parse(code, [{options}]):解析一段 JavaScript 代码;
  • parser.parseExpression(code, [{options}]):考虑到了性能问题,解析单个 JavaScript 表达式。

部分可选参数 options:

参数 描述
allowImportExportEverywhere 默认 import 和 export 声明语句只能出现在程序的最顶层,设置为 true 则在任何地方都可以声明
allowReturnOutsideFunction 默认如果在顶层中使用 return 语句会引起错误,设置为 true 就不会报错
sourceType 默认为 script,当代码中含有 import 、export 等关键字时会报错,需要指定为 module
errorRecovery 默认如果 babel 发现一些不正常的代码就会抛出错误,设置为 true 则会在保存解析错误的同时继续解析代码,错误的记录将被保存在最终生成的 AST 的 errors 属性中,当然如果遇到严重的错误,依然会终止解析

举个例子看得比较清楚:

1
2
3
4
5
6
const parser = require("@babel/parser");

const code = "const a = 1;";
const ast = parser.parse(code, {sourceType: "module"})
console.log(ast)
12345

{sourceType: "module"} 演示了如何添加可选参数,输出的就是 AST 语法树,这和在线网站 https://astexplorer.net/ 解析出来的语法树是一样的

@babel/generator

@babel/generator 可以将 AST 还原成 JavaScript 代码,提供了一个 generate 方法:generate(ast, [{options}], code)。

部分可选参数 options:

参数 描述
auxiliaryCommentBefore 在输出文件内容的头部添加注释块文字
auxiliaryCommentAfter 在输出文件内容的末尾添加注释块文字
comments 输出内容是否包含注释
compact 输出内容是否不添加空格,避免格式化
concise 输出内容是否减少空格使其更紧凑一些
minified 是否压缩输出代码
retainLines 尝试在输出代码中使用与源代码中相同的行号

接着前面的例子,原代码是 const a = 1;,现在我们把 a 变量修改为 b,值 1 修改为 2,然后将 AST 还原生成新的 JS 代码:

1
2
3
4
5
6
7
8
9
10
const parser = require("@babel/parser");
const generate = require("@babel/generator").default

const code = "const a = 1;";
const ast = parser.parse(code, {sourceType: "module"})
ast.program.body[0].declarations[0].id.name = "b"
ast.program.body[0].declarations[0].init.value = 2
const result = generate(ast, {minified: true})

console.log(result.code)

最终输出的是 const b=2;,变量名和值都成功更改了,由于加了压缩处理,等号左右两边的空格也没了。

代码里 {minified: true} 演示了如何添加可选参数,这里表示压缩输出代码,generate 得到的 result 得到的是一个对象,其中的 code 属性才是最终的 JS 代码。

@babel/traverse

当代码多了,我们不可能像前面那样挨个定位并修改,对于相同类型的节点,我们可以直接遍历所有节点来进行修改,这里就用到了 @babel/traverse,它通常和 visitor 一起使用,visitor 是一个对象,这个名字是可以随意取的,visitor 里可以定义一些方法来过滤节点,这里还是用一个例子来演示:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
const parser = require("@babel/parser");
const generate = require("@babel/generator").default
const traverse = require("@babel/traverse").default

const code = `
const a = 1500;
const b = 60;
const c = "hi";
const d = 787;
const e = "1244";
`
const ast = parser.parse(code)

const visitor = {
NumericLiteral(path){
path.node.value = (path.node.value + 100) * 2
},
StringLiteral(path){
path.node.value = "I Love JavaScript!"
}
}

traverse(ast, visitor)
const result = generate(ast)
console.log(result.code)

这里的原始代码定义了 abcde 五个变量,其值有数字也有字符串,我们在 AST 中可以看到对应的类型为 NumericLiteral 和 StringLiteral

然后我们声明了一个 visitor 对象,然后定义对应类型的处理方法,traverse 接收两个参数,第一个是 AST 对象,第二个是 visitor,当 traverse 遍历所有节点,遇到节点类型为 NumericLiteral 和 StringLiteral 时,就会调用 visitor 中对应的处理方法,visitor 中的方法会接收一个当前节点的 path 对象,该对象的类型是 NodePath,该对象有非常多的属性,以下介绍几种最常用的:

属性 描述
toString() 当前路径的源码
node 当前路径的节点
parent 当前路径的父级节点
parentPath 当前路径的父级路径
type 当前路径的类型

PS:path 对象除了有很多属性以外,还有很多方法,比如替换节点、删除节点、插入节点、寻找父级节点、获取同级节点、添加注释、判断节点类型等,可在需要时查询相关文档或查看源码,后续介绍 @babel/types 部分将会举部分例子来演示,以后的实战文章中也会有相关实例,篇幅有限本文不再细说。

因此在上面的代码中,path.node.value 就拿到了变量的值,然后我们就可以进一步对其进行修改了。以上代码运行后,所有数字都会加上100后再乘以2,所有字符串都会被替换成 I Love JavaScript!,结果如下:

1
2
3
4
5
const a = 3200;
const b = 320;
const c = "I Love JavaScript!";
const d = 1774;
const e = "I Love JavaScript!";

如果多个类型的节点,处理的方式都一样,那么还可以使用 | 将所有节点连接成字符串,将同一个方法应用到所有节点:

1
2
3
4
5
const visitor = {
"NumericLiteral|StringLiteral"(path) {
path.node.value = "I Love JavaScript!"
}
}

visitor 对象有多种写法,以下几种写法的效果都是一样的:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
const visitor = {
NumericLiteral(path){
path.node.value = (path.node.value + 100) * 2
},
StringLiteral(path){
path.node.value = "I Love JavaScript!"
}
}

const visitor = {
NumericLiteral: function (path){
path.node.value = (path.node.value + 100) * 2
},
StringLiteral: function (path){
path.node.value = "I Love JavaScript!"
}
}

const visitor = {
NumericLiteral: {
enter(path) {
path.node.value = (path.node.value + 100) * 2
}
},
StringLiteral: {
enter(path) {
path.node.value = "I Love JavaScript!"
}
}
}

const visitor = {
enter(path) {
if (path.node.type === "NumericLiteral") {
path.node.value = (path.node.value + 100) * 2
}
if (path.node.type === "StringLiteral") {
path.node.value = "I Love JavaScript!"
}
}
}

以上几种写法中有用到了 enter 方法,在节点的遍历过程中,进入节点(enter)与退出(exit)节点都会访问一次节点,traverse 默认在进入节点时进行节点的处理,如果要在退出节点时处理,那么在 visitor 中就必须声明 exit 方法。

@babel/types

@babel/types 主要用于构建新的 AST 节点,前面的示例代码为 const a = 1;,如果想要增加内容,比如变成 const a = 1; const b = a * 5 + 1;,就可以通过 @babel/types 来实现。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
const parser = require("@babel/parser");
const generate = require("@babel/generator").default
const traverse = require("@babel/traverse").default
const types = require('@babel/types')

const code = "const a = 1;"
const ast = parser.parse(code)

const visitor = {
VariableDeclaration(path) {
let left = types.binaryExpression("*", types.identifier("a"), types.numericLiteral(5))
let right = types.numericLiteral(1)
let init = types.binaryExpression("+", left, right)
let declarator = types.variableDeclarator(types.identifier("b"), init)
let declaration = types.variableDeclaration("const", [declarator])
path.insertAfter(declaration)
path.stop()
}
}

traverse(ast,visitor)
const result = generate(ast)
console.log(result.code)

字符串还原

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
const parser = require("@babel/parser");
const generate = require("@babel/generator").default
const traverse = require("@babel/traverse").default

const code = `console['\u006c\u006f\u0067']('\u0048\u0065\u006c\u006c\u006f\u0020\u0077\u006f\u0072\u006c\u0064\u0021')`
const ast = parser.parse(code)

const visitor = {
StringLiteral(path) {
// 以下方法均可
// path.node.extra.raw = path.node.rawValue
// path.node.extra.raw = '"' + path.node.value + '"'
// delete path.node.extra
delete path.node.extra.raw
}
}

traverse(ast, visitor)
const result = generate(ast)
console.log(result.code)

表达式还原

想要执行语句,我们需要了解 path.evaluate() 方法,该方法会对 path 对象进行执行操作,自动计算出结果,返回一个对象,其中的 confident 属性表示置信度,value 表示计算结果,使用 types.valueToNode() 方法创建节点,使用 path.replaceInline() 方法将节点替换成计算结果生成的新节点,替换方法有一下几种:

  • replaceWith:用一个节点替换另一个节点;
  • replaceWithMultiple:用多个节点替换另一个节点;
  • replaceWithSourceString:将传入的源码字符串解析成对应 Node 后再替换,性能较差,不建议使用;
  • replaceInline:用一个或多个节点替换另一个节点,相当于同时有了前两个函数的功能。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
const parser = require("@babel/parser");
const generate = require("@babel/generator").default
const traverse = require("@babel/traverse").default
const types = require("@babel/types")

const code = `
const a = !![]+!![]+!![];
const b = Math.floor(12.34 * 2.12)
const c = 10 >> 3 << 1
const d = String(21.3 + 14 * 1.32)
const e = parseInt("1.893" + "45.9088")
const f = parseFloat("23.2334" + "21.89112")
const g = 20 < 18 ? '未成年' : '成年'
`
const ast = parser.parse(code)

const visitor = {
"BinaryExpression|CallExpression|ConditionalExpression"(path) {
const {confident, value} = path.evaluate()
if (confident){
path.replaceInline(types.valueToNode(value))
}
}
}

traverse(ast, visitor)
const result = generate(ast)
console.log(result.code)

删除未使用变量

删除多余变量,首先要了解 NodePath 中的 scope,scope 的作用主要是查找标识符的作用域、获取并修改标识符的所有引用等,删除未使用变量主要用到了 scope.getBinding() 方法,传入的值是当前节点能够引用到的标识符名称,返回的关键属性有以下几个:

  • identifier:标识符的 Node 对象;
  • path:标识符的 NodePath 对象;
  • constant:标识符是否为常量;
  • referenced:标识符是否被引用;
  • references:标识符被引用的次数;
  • constantViolations:如果标识符被修改,则会存放所有修改该标识符节点的 Path 对象;
  • referencePaths:如果标识符被引用,则会存放所有引用该标识符节点的 Path 对象。

所以我们可以通过 constantViolations、referenced、references、referencePaths 多个参数来判断变量是否可以被删除

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
const parser = require("@babel/parser");
const generate = require("@babel/generator").default
const traverse = require("@babel/traverse").default

const code = `
const a = 1;
const b = a * 2;
const c = 2;
const d = b + 1;
const e = 3;
console.log(d)
`
const ast = parser.parse(code)

const visitor = {
VariableDeclarator(path){
const binding = path.scope.getBinding(path.node.id.name);

// 如标识符被修改过,则不能进行删除动作。
if (!binding || binding.constantViolations.length > 0) {
return;
}

// 未被引用
if (!binding.referenced) {
path.remove();
}

// 被引用次数为0
// if (binding.references === 0) {
// path.remove();
// }

// 长度为0,变量没有被引用过
// if (binding.referencePaths.length === 0) {
// path.remove();
// }
}
}

traverse(ast, visitor)
const result = generate(ast)
console.log(result.code)

删除冗余逻辑代码

AST 处理思路以及代码:

  1. 筛选出 BooleanLiteral 和 NumericLiteral 节点,取其对应的值,即 path.node.test.value;
  2. 判断 value 值为真,则将节点替换成 consequent 节点下的内容,即 path.node.consequent.body;
  3. 判断 value 值为假,则替换成 alternate 节点下的内容,即 path.node.alternate.body;
  4. 有的 if 语句可能没有写 else,也就没有 alternate,所以这种情况下判断 value 值为假,则直接移除该节点,即 path.remove()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
const parser = require("@babel/parser");
const generate = require("@babel/generator").default
const traverse = require("@babel/traverse").default
const types = require('@babel/types');

const code = `
const example = function () {
let a;
if (false) {
a = 1;
} else {
if (1) {
a = 2;
}
else {
a = 3;
}
}
return a;
};
`
const ast = parser.parse(code)

const visitor = {
enter(path) {
if (types.isBooleanLiteral(path.node.test) || types.isNumericLiteral(path.node.test)) {
if (path.node.test.value) {
path.replaceInline(path.node.consequent.body);
} else {
if (path.node.alternate) {
path.replaceInline(path.node.alternate.body);
} else {
path.remove()
}
}
}
}
}

traverse(ast, visitor)
const result = generate(ast)
console.log(result.code)

switch-case 反控制流平坦化

控制流平坦化是混淆当中最常见的,通过 if-else 或者 while-switch-case 语句分解步骤

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
const _0x34e16a = '3,4,0,5,1,2'['split'](',');
let _0x2eff02 = 0x0;
while (!![]) {
switch (_0x34e16a[_0x2eff02++]) {
case'0':
let _0x38cb15 = _0x4588f1 + _0x470e97;
continue;
case'1':
let _0x1e0e5e = _0x37b9f3[_0x50cee0(0x2e0, 0x2e8, 0x2e1, 0x2e4)];
continue;
case'2':
let _0x35d732 = [_0x388d4b(-0x134, -0x134, -0x139, -0x138)](_0x38cb15 >> _0x4588f1);
continue;
case'3':
let _0x4588f1 = 0x1;
continue;
case'4':
let _0x470e97 = 0x2;
continue;
case'5':
let _0x37b9f3 = 0x5 || _0x38cb15;
continue;
}
break;
}

AST 还原思路:

  1. 获取控制流原始数组,将 '3,4,0,5,1,2'['split'](',') 之类的语句转化成 ['3','4','0','5','1','2'] 之类的数组,得到该数组之后,也可以选择把 split 语句对应的节点删除掉,因为最终代码里这条语句就没用了;
  2. 遍历第一步得到的控制流数组,依次取出每个值所对应的 case 节点;
  3. 定义一个数组,储存每个 case 节点 consequent 数组里面的内容,并删除 continue 语句对应的节点;
  4. 遍历完成后,将第三步的数组替换掉整个 while 节点,也就是 WhileStatement。

不同思路,写法多样,对于如何获取控制流数组,可以有以下思路:

  1. 获取到 While 语句节点,然后使用 path.getAllPrevSiblings() 方法获取其前面的所有兄弟节点,遍历每个兄弟节点,找到与 switch() 里面数组的变量名相同的节点,然后再取节点的值进行后续处理;
  2. 直接取 switch() 里面数组的变量名,然后使用 scope.getBinding() 方法获取到它绑定的节点,然后再取这个节点的值进行后续处理。